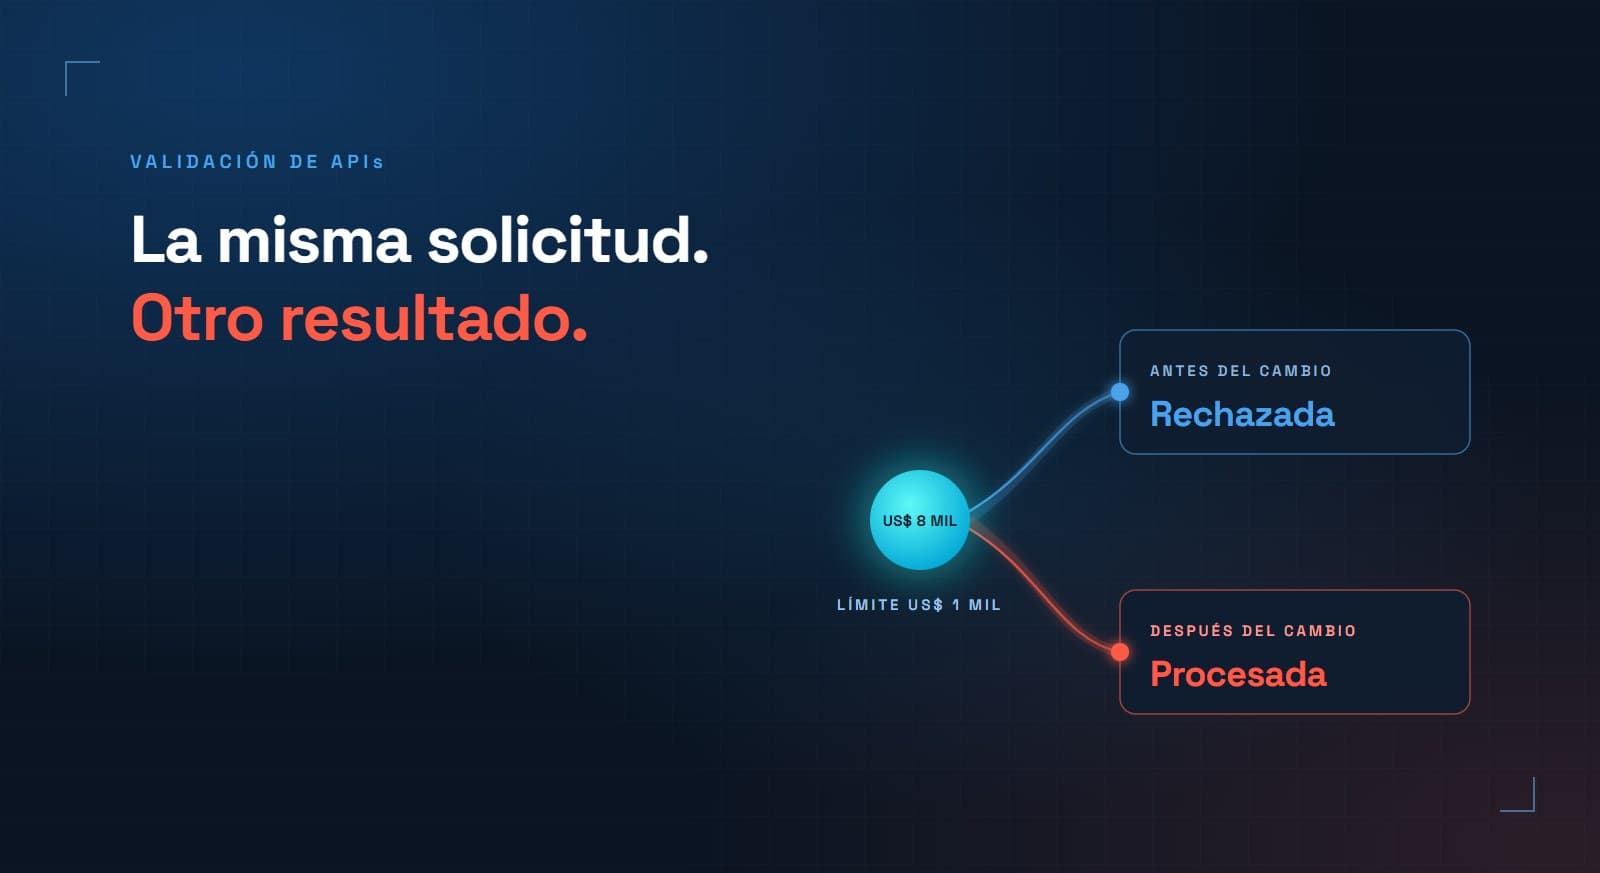
Una transferencia de US$ 8.000 debería rechazarse porque el límite permitido es de US$ 1.000. Después de una actualización, la API empieza a aceptarla. El servicio sigue en línea, la solicitud tiene el formato esperado y la respuesta dice que la operación se completó.
En este ejemplo hipotético, la falla está en el monto que la aplicación dejó pasar. Si solo miras la disponibilidad del servicio o la estructura de la respuesta, no ves el problema.
Es por eso que la validación de APIs tras cambios tiene que revisar las reglas que cada operación debe cumplir. Permisos, límites, orden de los pasos y manejo de errores son parte de este trabajo, incluso cuando el contrato de la API no cambia.
Si lideras Ingeniería, Arquitectura o Seguridad, el reto es mantener esa evaluación al ritmo de las entregas. Al mismo tiempo, no puedes perder de vista lo que una falla le cuesta al negocio.
Cómo un cambio puede introducir riesgos en las APIs
El comportamiento de una API depende del código que ejecuta la operación, de los servicios que consulta, de la configuración y de los controles aplicados a lo largo del flujo. Un cambio en cualquiera de esos puntos puede alterar el resultado.
Piensa en una actualización del componente que verifica los límites de transferencia. El endpoint sigue recibiendo los mismos campos y devolviendo la misma estructura de respuesta. Aun así, si la verificación deja de aplicarse en una de las condiciones previstas, la operación se aprueba cuando no debería.
Lo mismo pasa al revisar permisos, cambiar de proveedor o modificar el manejo de una respuesta de error. El cambio parece limitado a una parte del sistema, pero sus efectos llegan a todo lo que depende de ella.
La especificación muestra los cambios en endpoints y contratos. Los cambios internos y en dependencias también alteran el comportamiento, y esos no aparecen en el documento.
Qué son las fallas de lógica de negocio en las APIs
Una falla de lógica de negocio ocurre cuando la aplicación permite una operación que contradice las reglas del proceso que debería ejecutar. Una entrada puede tener el formato correcto, usar una credencial válida y, aun así, producir un resultado indebido.
En la transferencia, el monto informado es un número válido. El problema aparece cuando se compara con el límite permitido para esa operación.
Otras reglas dependen del estado del proceso. Un pedido solo puede despacharse después de confirmar el pago. Un reembolso tiene que considerar lo que ya se devolvió. Una aprobación puede exigir pasos que no se deben saltar.
La guía de pruebas de OWASP incluye la evaluación de flujos que permiten saltar, repetir o ejecutar pasos fuera del orden previsto. Los casos de prueba parten de los requisitos específicos de cada aplicación. OWASP Web Security Testing Guide.
Qué comportamientos hay que volver a evaluar
Los ejemplos de abajo son hipotéticos. Cada uno muestra una situación que vale la pena investigar, según lo que haya cambiado.
Acceso con otro perfil
Una revisión de permisos permite que un usuario autenticado consulte información de otra cuenta. La evaluación tiene que verificar que la respuesta traiga solo los datos que ese usuario debería ver.
Repetición de una operación
Una integración reenvía una solicitud después de no recibir la confirmación a tiempo. Si la operación debería producir un único efecto, la evaluación tiene que verificar si la repetición generó un cobro, una reserva o una baja de inventario de más.
Falla en una dependencia
Un servicio externo deja de responder durante el procesamiento. Aquí hay que verificar el estado final de la operación y si la API informó un resultado acorde con lo que de verdad pasó.
Uso por encima de lo previsto
Una funcionalidad acepta solicitudes que, una por una, están permitidas, pero cuyo uso repetido perjudica al negocio. Esta preocupación aparece en el API6:2023 de OWASP, que trata del acceso irrestricto a flujos de negocio sensibles, como compras y reservas. OWASP API Security Top 10.
Estos casos exigen criterios de aceptación claros. El equipo tiene que saber qué resultado está permitido, en qué condiciones y qué debe pasar cuando la operación no se puede completar.
Por dónde empezar cuando no se puede volver a evaluar todo
Una forma práctica de priorizar la validación de APIs es cruzar lo que cambió con las consecuencias de un comportamiento indebido.
Un cambio en una consulta informativa y un cambio en la autorización de pagos no piden el mismo esfuerzo. También importa saber cuántos sistemas dependen del componente modificado y qué condiciones ya verifica la cobertura actual.
Para definir el alcance, conviene responder:
- ¿Qué operaciones dependen del código, la configuración o la integración que cambió?
- ¿Qué reglas tienen que seguir siendo válidas en esas operaciones?
- ¿Qué pasa si una de esas reglas deja de aplicarse?
- ¿Las pruebas existentes verifican ese comportamiento, incluso ante rechazos, repeticiones y fallas?
Las respuestas muestran dónde la evaluación tiene que ir más a fondo. Un componente compartido por varios servicios, por ejemplo, puede exigir un análisis más amplio de lo que sugiere el endpoint modificado.
El papel de la validación continua de APIs
La validación continua de APIs es la práctica de volver a evaluar su comportamiento en cada versión del sistema. La cobertura se revisa a medida que surgen cambios y nuevos riesgos.
Una suite de regresión cubre una parte importante de este trabajo. Pero tiene que acompañar los requisitos actuales: una prueba creada para la integración anterior no verifica una condición que solo el nuevo proveedor introdujo.
En la práctica, la rutina de validación tiene dos frentes: mantener las verificaciones relevantes e investigar lo que todavía no está cubierto. La frecuencia y la profundidad de estas evaluaciones dependen de qué tan críticas son las APIs y de lo que cambió.
También hay una tarea de alineación. Producto y negocio ayudan a explicitar los límites de la operación; Ingeniería, QA y Seguridad convierten esas reglas en comportamientos verificables. Cuando el resultado esperado queda implícito, es más difícil demostrar que se sigue respetando.
Cómo verificar que una corrección resolvió el riesgo
Un riesgo identificado necesita información suficiente para orientar el tratamiento: la operación afectada, las condiciones de la evaluación, el comportamiento observado y el resultado esperado.
Después de la corrección, el mismo caso pasa por una nueva evaluación. En el ejemplo de la transferencia, eso significa verificar que el monto por encima del límite vuelva a rechazarse. Según el alcance del cambio, también puede ser necesario evaluar condiciones cercanas, como operaciones dentro del límite.
Esta nueva prueba confirma el efecto de la corrección sobre el comportamiento encontrado y deja el resultado registrado para los equipos responsables.
Cómo el ARC ayuda a volver a evaluar las APIs
El R/Pulse API Resilience Core (ARC) realiza validaciones de APIs críticas para identificar riesgos y apoyar su tratamiento. Sigue los cambios en la especificación y dirige nuevas validaciones a lo que cambió.
Cuando encuentra un riesgo, presenta el comportamiento observado y evidencias para reproducirlo, con una indicación de prioridad. Después del tratamiento, una nueva evaluación verifica si el comportamiento identificado sigue ocurriendo.
Conclusión
Una prueba aprobada en la versión anterior no garantiza nada sobre la versión actual. Basta con que los permisos, las integraciones o las reglas hayan cambiado en el camino. La transferencia de US$ 8.000 del inicio pasaría cualquier verificación de disponibilidad o de contrato.
Lo que encuentra este tipo de falla es volver a evaluar las reglas de negocio junto con cada cambio relevante. Así, el equipo sabe si un cambio puede avanzar, qué necesita corrección y qué comportamientos todavía requieren investigación.
Conoce R/Pulse ARC y habla con nuestro equipo sobre la validación de tus APIs.